研究 ·
AI Cosmos:面向情境学习的智能体基础设施
让 AI 不只帮你拿到答案,而是陪你在真实情境里把事情做会。我们发布 AI Cosmos 技术报告,并用两项预注册随机对照实验检验它。
1929 年,怀特海在《教育的目的》里写道:教育的核心问题,是不让知识变成「惰性知识」——能复述,却用不出来。近一个世纪后,生成式 AI 让解释、示范和答案随取随用,这个老问题却以新的形式回来了。
学习者越来越能流畅地复述 AI 给出的概念和解法,独立运用的能力却没有同步提高。我们把这种落差称为表现—能力脱钩:讲得清快速排序的分治思路,却写不出健壮的实现;背得出法律条文,却套用不到陌生的案情上。
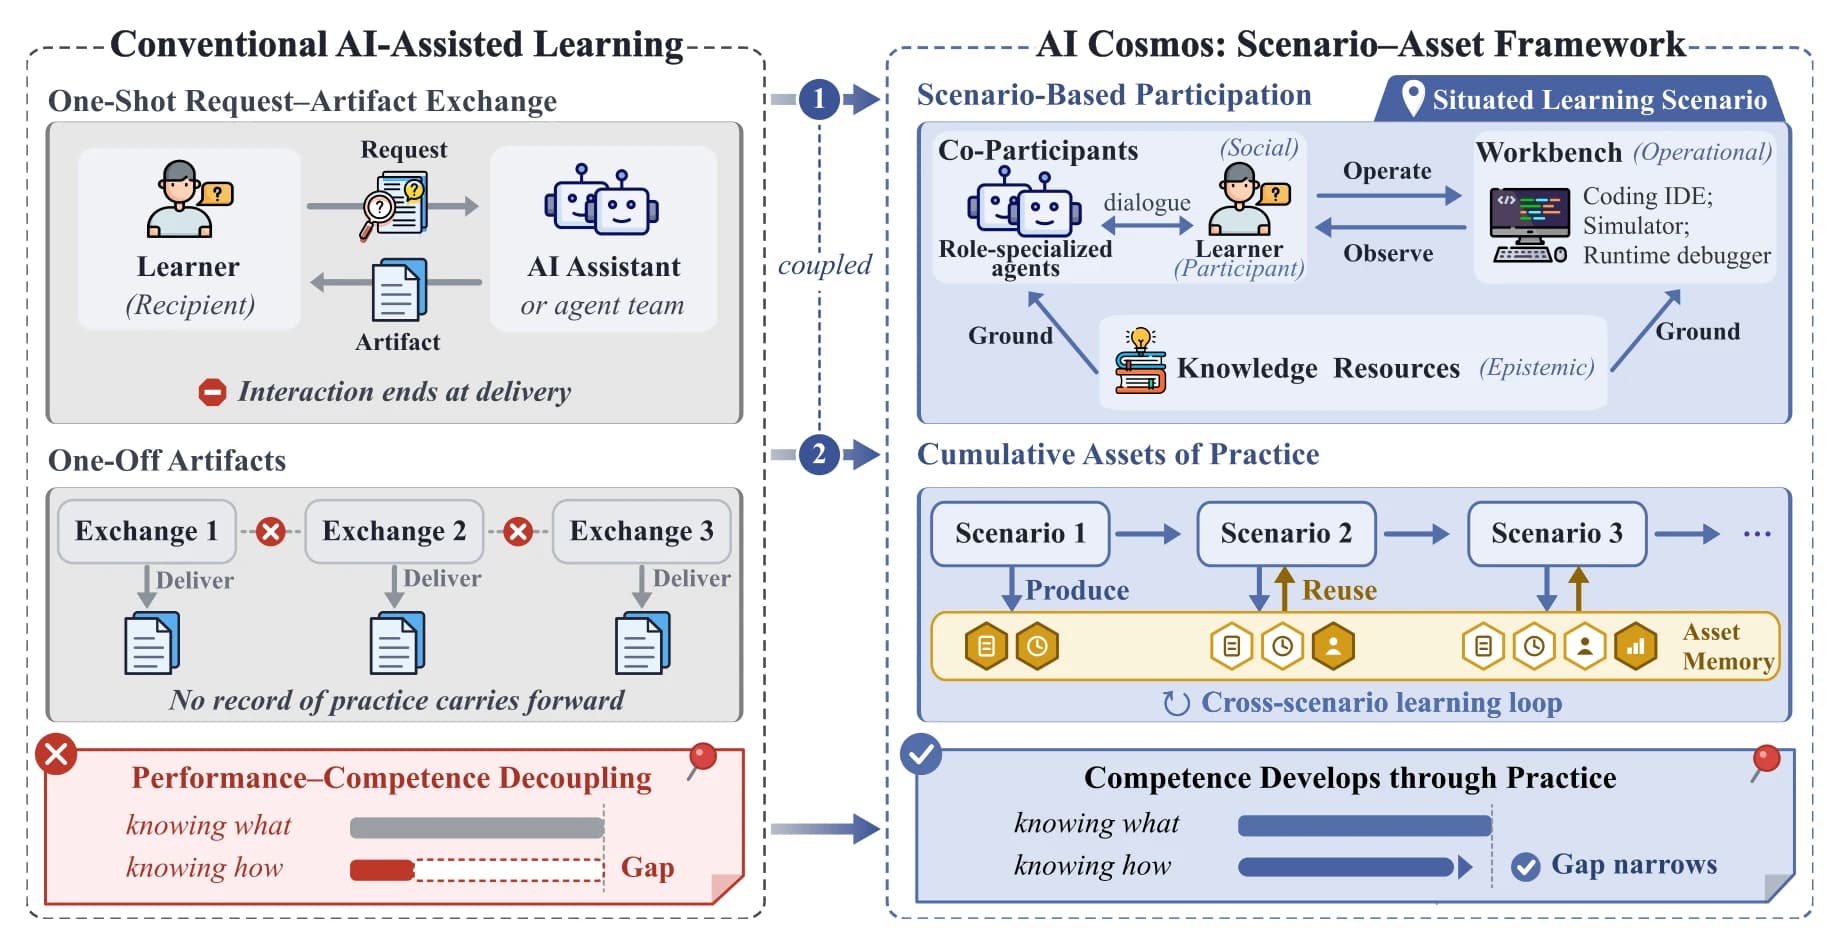
症结不在模型能力,而在交互方式。如今大多数 AI 教育应用沿用「请求—产物交换」:学习者提出请求,系统交付解释或成品,交互随之结束。学习者自己的尝试、反馈和修改都发生在交互之外,下一次学习也无从接续。
当知识不只是被表达,而是被实践、被分享,并沉淀为可复用的智识资产时,教育才真正具有变革性。
AI Cosmos 宣言
两个转变:情境与资产
AI Cosmos 围绕两个互补的转变来组织 AI 辅助学习:从请求—产物交换转向情境化参与,从一次性产物转向可积累的实践资产。
情境化参与
每个学习活动都被组织成一个情境:围绕一个学习目标,配置三个维度的实践。学习者和智能体通过对话协作,需要时直接操作共享的工作台,操作的结果再回到对话里,指引下一步。
- 社会 · Social角色化智能体与学习者讲解者、导师、陪练等角色由智能体担任,与学习者一同参与;角色决定谁负责什么、能做什么。
- 认知 · Epistemic知识资源与任务相关的资料、数据和过往资产,在情境中随时可以检索。
- 操作 · Operational可执行工作台编程 IDE、仿真器等有状态的环境,学习者和智能体都能在里面创建、修改、运行和检查对象。
可积累的实践资产
情境结束后留下的不只是最终答案。AI Cosmos 把实践的过程和结果保存为带溯源和依赖关系的资产,后续情境可以检索、组合,并在此之上继续:
- 角色规格
- 可复用的参与者角色定义,包括职责、行为规范和适用条件。
- 情境规格
- 完整或部分的情境配置,可以直接实例化,也可以改编。
- 知识产物
- 在工作台里创建或修改的成果,如幻灯片、批注文档、代码模块。
- 过程记录
- 参与者的操作、反馈、批评和修改序列,记下成果是怎样形成的。
- 经验轨迹
- 从执行中提炼的结构化证据,如操作结果、失败案例、配置与表现之间的关系。
系统架构
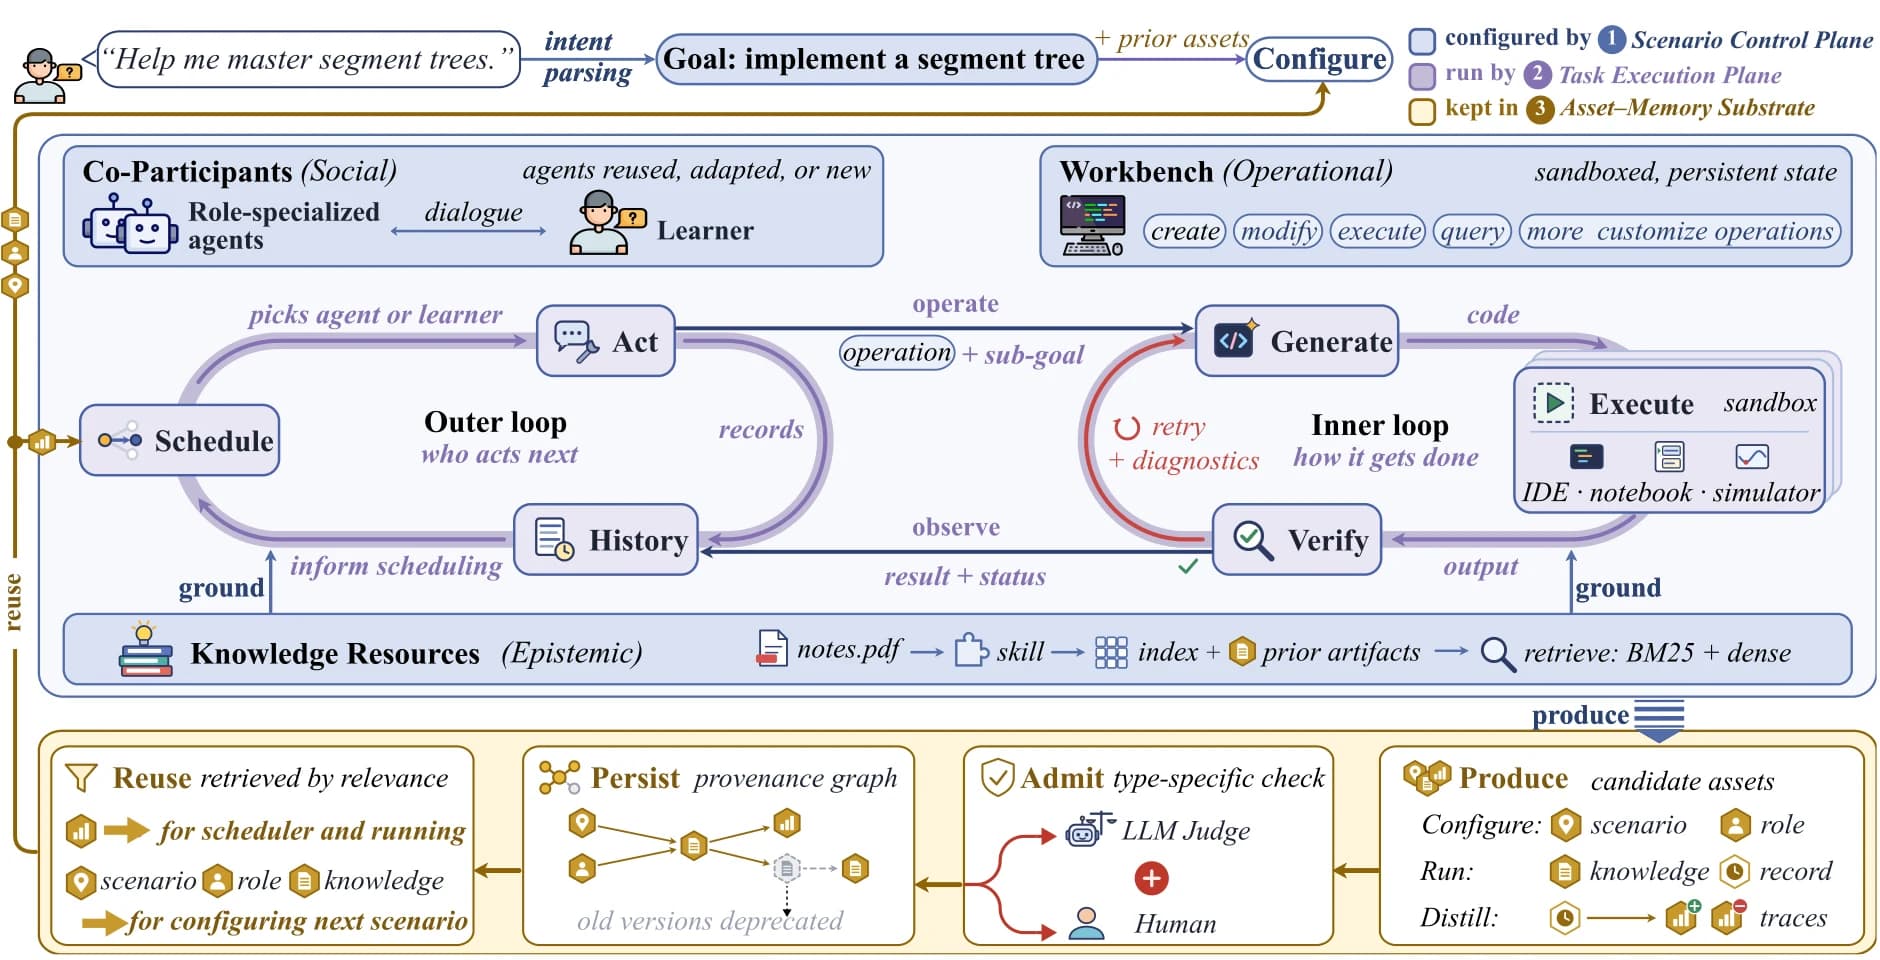
AI Cosmos 用三个相互连接的部分实现这个框架。
- 情境控制平面
- 把学习者的请求解析为学习目标,再按目标配置所需的角色、知识库和工作台。有相关的历史资产就复用或改编,没有就从头生成,而不是套用一支固定的智能体团队。
- 任务执行平面
- 外环根据交互历史决定下一位行动的参与者,在讲解、提问、批评、使用工具和交还学习者之间灵活切换;内环在沙箱化的工作台里执行操作,按「生成—执行—验证」循环、带着诊断信息重试。学习者随时可以介入,直接修改工作台的状态。
- 资产记忆底座
- 从情境配置和实践记录中产出候选资产,按类型校验后准入(知识产物还需人工确认),以溯源图持久保存;旧版本标记为弃用但保留可回滚,供后续情境检索复用。
实验一:法考备考中的法律推理
法律问题求解不仅要记住法条,还要从陌生的案情中识别相关规则并加以运用。我们开展了一项预注册的三臂随机对照试验:131 名学生被随机分到普通 LLM 助手、被提示扮演专家导师的 LLM(LLM 扮老师)和 AI Cosmos 三组,按预注册的数据完整性标准筛选后,分析样本为 111 人(每组 37 人)。三组使用同一个底座模型,差别只在交互架构。
0–100 分制。AI Cosmos 相对普通 LLM 的即时增益差异显著(p = 0.018,d = 0.56);相对 LLM 扮老师的优势、四周随访的组间差异未达统计显著。
AI Cosmos 组的学习增益比普通 LLM 组高 7.0 个百分点(Cohen’s d = 0.56,p = 0.018),控制前测成绩后结论不变。只给同一个模型加上老师人设,并没有带来可检测的提升。
差别来自交互的结构。三组学生的总输入量相同(中位数约 7,100 字),AI Cosmos 组的对话轮次却是对照组的 1.7 倍左右(51.0 轮,对照组约 29 轮),每轮字数少约 40%——一次性的提问变成了多轮的来回推敲。优势主要集中在情境化的应用题上,在基础高、低不同的学生中方向一致,学生感受到的认知负荷也没有增加。
实验二:竞赛编程中的可执行工作台
第二项研究聚焦操作维度。竞赛编程要求学习者不仅理解算法,还要亲手实现、运行、调试出正确高效的程序。我们开展了预注册的三臂随机对照试验,按能力分为基础算法和数据结构两条课程线,54 名学生完成了全部流程。AI Cosmos 组在情境中配备可执行的编程工作台;它和 LLM 扮老师组都不直接给出完整代码,普通 LLM 组不设限制。后测是两道没见过的新题,由两位 NOI / ACM 金牌选手命题,并在不知分组的情况下评阅代码。
G4 表示目标算法的实现基本完整、正确。掌握比例相对 LLM 扮老师的差异显著(p = 0.009);后测总分的总体差异未达统计显著(p = 0.20),样本量有限。
只看分数,AI Cosmos 和普通 LLM 相差不大,两组得分提交的比例也接近(82% 和 85%)。但细看代码,AI Cosmos 组 55% 的提交真正实现了目标算法,普通 LLM 组只有 38%;不用目标算法、只靠「凑分」通过的提交,AI Cosmos 组也最少。
工作台对基础较弱的学习者帮助最大:在基础算法线,AI Cosmos 组的后测比 LLM 扮老师组高出 31.4 分。同时,只有 AI Cosmos 组的成绩和学生先前的能力明显相关(r = 0.59,p = 0.008),两个对照组几乎为零——学生能直接拿到代码时,分数反映的更多是助手的能力。要求学生自己构建、运行和修复程序,分数才重新成为衡量本人能力的尺子。
结语
两项研究指向同一个结论:有效的 AI 学习系统,应当让交互结构与目标能力的形态相匹配。推理本身就是练习对象的领域,结构化的对话更有效;能力要在构建、测试和修改中形成的领域,可执行的工作台不可或缺。AI Cosmos 把引导和学习者亲手实践的产物结合在一起,并把每一次实践沉淀为下一次学习的起点。